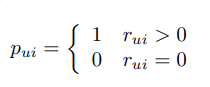글

라벨이 Recommender System인 게시물 표시

Wide & Deep Learning for Recommender Systems 리뷰
이미지
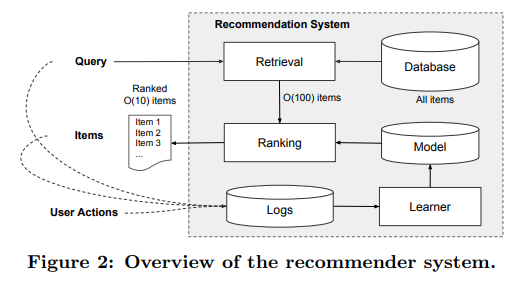
링크 :  https://arxiv.org/pdf/1606.07792v1.pdf ABSTRACT 1. INTRODUCTION contributions • The Wide & Deep learning framework for jointly training feed-forward neural networks with embeddings and linear model with feature transformations for generic recommender systems with sparse inputs. • 구글 플레이 위에 직접 구현이 되어 있음. • TensorFlow 공식 홈페이지에 오픈소스화 . While the idea is simple, we show that the Wide & Deep framework significantly improves the app acquisition rate on the mobile app store, while satisfying the training and serving speed requirements. 2. RECOMMENDER SYSTEM OVERVIEW 아래의 Figure 2가 전체적인 시스템 overview 이다.  유저가 방문하면 해당 컨텍스트를 통하여 쿼리를 생성 한다.  유저 데이터를 통하여 어떤 앱이 가장 효율이 좋을지에 따라 리스팅을 한다.  milion의 앱이 있기 때문에 10 밀리 세컨드에 리턴하는 것은 좀 어려운 문제라고 한다. 따라서 사람이 정한 룰 + 머신 러닝을 통하여 처음에 100개로 줄인다. 그후 랭킹을 매긴다. The scores are usually P(y|x), the probability of a user action label y given the features x, including user features (e.g., country, language, demographics)...

Factorization machines 리뷰

이미지
논문 링크 :  https://www.csie.ntu.edu.tw/~b97053/paper/Rendle2010FM.pdf Abstract 이 논문에서는 SVM과 Factorization Model의 장점을 결합한 새로운 모델을 다룬다. 두개의 모델 모두 feature vector를 다루지만 FM은 factorized 파라미터를 사용하고 이를 통해서 sparse한 데이터를 SVM 보다 더욱 잘 다룬다고 한다. FM은 SVM에 비하여 선형 시간을 가진다고 한다. 일반적인 MF 모델은 general한 인풋에는 적절하지 않아서 이를 해결하려고 한다. SVM은 prediction을 하려면 데이터가 어느정도 저장이 되어야 하지만 MF는 factorization 함. I. INTRODUCTION SVM이 sparse하고 convex(비선형)한 kernel space에서는 효과적이지 않음을 다루려고 한다. FM 모델은 일반적인 데이터에는 적용하기 어렵다. 이 둘의 장점을 결합한 Factorization Machine을 소개한다. 또한 이는 선형적으로 계산이 가능하며 선형적인 파라미터가 필요 하다. In total, the advantages of our proposed FM are: FMs allow parameter estimation under very sparse data where SVMs fail.  FMs have linear complexity, can be optimized in the primal and do not rely on support vectors like SVMs. We show that FMs scale to large datasets like Netflix with 100 millions of training instances.  FMs are a general predictor that can work with any real valued feature vector. In co...

Neural Collaborative Filtering 리뷰

이미지
논문 링크 :  https://arxiv.org/pdf/1708.05031.pdf 코드 링크 :  https://github.com/hexiangnan/neural_collaborative_filtering Absctract 해당 논문은 추천 시스템의 implicit 데이터를 다룬다. 기존 논문에서 Deep Neural Net 방식의 적용이 자연어 처리, 음성 인식등과 같이 메인 로직이 아닌 보조할 수 있는 로직에 국한되어 있다고 한다. 해당 논문에서는 Matrix Factorization의 두 행렬의 inner product 부분을 딥러닝 방식으로 교체한 모델을 설명하려는듯 하다. 2. PRELIMINARIES 2.1 Learning from Implicit Data M,N은 각각 유저, 아이템의 갯수 이다. Yui는 유저 u, 아이템 i간의 상호작용이 발견되면 1이고 아니면 0이다. 2.2 Matrix Factorization 일반적인 MF 수식을 나타낸다. K는 latent space의 demension이다.  3. NEURAL COLLABORATIVE FILTERING 3.1 General Framework 3.2 Generalized Matrix Factorization (GMF) 3.3 Multi-Layer Perceptron (MLP) NCF에서 유저, 아이템 모델 벡터를 concate 한다는 개념은 직관적으로 이해가 가능하지만 그거 자체만으로는 설명이 어렵다고 한다. 여기서는 따라서 둘사이에 hidden layer로 MLP를 둔다고 한다.  MLP 3.4 Fusion of GMF and MLP GMF와 1 레이어 MLP를 단순하게 concate를 하면 다음과 같이 설명할 수 있다. concate GMF with one layer MLP 해당 수식만으로는 한계점이 존재하는데, 두 레이어의 크기는 동일해야하며  두 ...

BPR: Bayesian Personalized Ranking from Implicit Feedback 리뷰

이미지
논문 링크 :  https://arxiv.org/ftp/arxiv/papers/1205/1205.2618.pdf 코드 링크 :  https://github.com/benfred/implicit 해당 논문은 2009년도에 작성되었습니다. UAI 2019 - Association for Uncertainty in Artificial Intelligence 라는 AI 컨퍼런스에 제출된듯 합니다. 이번 논문도 저번 논문 처럼 implict 피드백에 대한 논문 입니다. 해당 논문은 새로운 모델을 생성했다기 보다는 기존 모델의 최적화 방법을 좀더 좋은 방법으로 고안하고 성능이 향상되었다는 것으로 보입니다. 1. Introduction 해당 논문에서는 item recommendation을 주로 다룬다고 합니다. implicit한 데이터들이 얻기도 쉽고, 현실적인 데이터라고 언급하고 있습니다. contribution 1. We present the generic optimization criterion BPR-Opt derived from the maximum posterior estimator for optimal personalized ranking. We show the analogies of BPR-Opt to maximization of the area under ROC curve. 2. BPR-Opt를 최대화 하는데에 있어서 LearnBPR를 도입. 이는 bootstrap sampling을 통한 SGD를 사용. 3. LearnBPR를 기존의 SOTA 알고리즘에 대하여 적용. 4. 개인화 랭킹 모델에 대하여 BPR가 다른 모델들보다 좋다는 것을 보임. 2. Related Work 저번 논문처럼 kNN이 언급 되어 있습니다. 또한 SVD, MF등 다른 알고리즘도 추가되어 있습니다. 3. Personalized Ranking 3.1 Formalization U = 모든 유저 I = 모든 ...

Collaborative Filtering for Implicit Feedback Datasets 리뷰

이미지
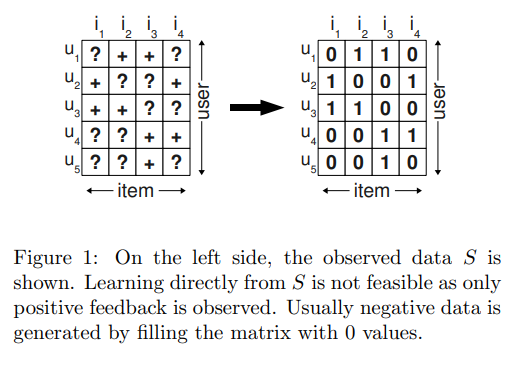
논문 링크 :  http://yifanhu.net/PUB/cf.pdf 코드 링크 :  https://github.com/benfred/implicit 해당 논문은 2008년도에 작성 되었습니다. 추천 시스템의 명확한 피드백이 아닌 내재되어 있는 피드백에 대하여 다룬 논문 입니다. 명확하다는 것은 예를 들어서 1-5점, 구매 유무가 될수 있을듯 하고 내재되어 있는 피드백은 유저의 체류 시간 등이 될 수 있습니다. 해당 모델의 이전 모델은 KNN같은 Neighbor 모델인걸로 보아서 최초의 approach로 보입니다.(아닐수도!) 아래가 해당 논문의 수식 입니다. u : 유저 i : 아이템 Xu : 유저 벡터 Yi : 아이템 벡터 R : 유저가 해당 아이템을 2번 보면 2. 70% 정도 보면 0.7이다. P(preference) : 해당 유저가 해당 아이템을 사용하였으면 1 or 0 이는 유저 u, 아이템 i의 내적으로도 표현이 가능하다고 함. C(confidence) : 그냥 TV를 봤기 때문에 채널을 보았거나, 나는 싫어하지만 친구 선물을 위해 주는 경우를 처리하기 위해서 만들어 졌다고 한다. 수식 뒤의 term은 regularization을 위함. 관측값 - 예측값을 최소화 하는 전형적인 수식으로 볼 수 있음. 아래의 수식이 word2vec(glove), mf등에서 자주 사용되는 형식이라고 합니다. 최적화 최적화는 alternating-least-square 방법으로 진행하였으며 아래의 수식을 번갈아 계산 하는데 이는 얼핏 보면 원래의 식에서 각각을 추출해낸 것으로 짐작할 수 있다. 해당 논문에서는 데이터가 매우 커져서 SGD를 사용하지 않았다고 합니다. xu를 업데이트 하는데에 있어서 다른 변수와 연관성이 없기 때문에 병렬로 계산이 가능하다고 합니다. 또는 당시에 SGD가 유세하지 않았을수도 있다고 합니다. 아래의 C는 rui를 통해서 다시 표현할 수...